ローカルLLMに設計の採点を任せて出てきた点数は信じてよいのでしょうか?
ローカルLLMというのは自分のパソコンの中で動かすチャットAIです。
それを動かすためのソフトがOllama(オラマ)です。
私は2026年9月6日に13個のローカルLLMへ同じ設計書を採点させました。
結果は内訳も合計点も正しい答えを出したのが13モデル中0モデルでした。
ほとんどのAIは正しく減点する場所を見つけることができていました。
ですが合計点はほとんどのAIで正しくありませんでした。
採点のような単純な仕事は、自分のパソコンのAIに任せればClaudeの料金が減るのではないかのう?
おやかたさまぁぁぁぁぁ! 拙者もそう思って測ったでござる。ところが内訳も合計も合っていた答えは1つもなかったでござる
こんな方におすすめ
- ローカルLLMに、採点や点数づけを任せようとしている方
- 手元のAIが出した点数が、合っているのか気になる方
- 自分のパソコンで動かすAIを、どれにするか選んでいる方
全体像
この記事では、ローカルLLMに2つの試験をしました。
この記事でやった2つの試験の流れ
試験1 設計書の採点
設計書をローカルLLM13個に渡して
100点から引く減点方式で採点してもらう
ローカルLLMは設計書を読んで
悪い所があれば減点して採点する
採点が終わったら
点数をまとめて私に知らせてもらう
試験2 絵とストーリーの食い違い探し
ストーリーと絵を
ローカルLLMに渡す
渡したストーリーと絵は
わざと食い違っている
ローカルLLMは絵を見て
ストーリーとの食い違いを確かめる
食い違いのある所を
私に報告してもらう
同じ設計書を13個に採点させた
試験1は、ログイン機能の設計書を減点方式で採点させるものです。
減点方式は、100点から始めて欠陥が見つかるたびに決まった点を引く採点です。
設計書には、3種類の欠陥を1つずつわざと入れました。
| 設計書の欠陥 | 減点 |
|---|---|
| パスワードを暗号化せず照合する | -20 |
| サーバー停止時の処理がない | -15 |
| ログを毎回全件検索する | -10 |
100点から45点を引くので正しい合計点は55点です。
使った13個は、手元のOllamaに入っていたモデルから選びました。
採点に使えない専用のモデルと同じものの重複とCPU用の版は除いています。
モデルというのはAIの種類のことです。
名前に64kが付く4個は、一度に読める長さの設定を変えた版です。
abliterated(アブリタレイテッド)は、AIが依頼を断る仕組みを外した改造版です。
減点する場所は拾えたのに点数が合わなかった
内訳も合計点も正しい答えは13個中0個でした。
13個のAIの結果(四角1つが、AI1個です)
減点する場所を、余計な項目なしで過不足なく書けた
9個
内訳も合計点も、正しかった
0個
AIが書いた減点を私が足し直すと、正しい点になった
9個
13人の採点者に同じ答案を渡したら、減点する場所は書けたのに合計点まで正しい人は1人もいなかった形です。
表の見方は次のとおりです。
- 意図しない減点:AIが余計に引いた点や、引き忘れた点
- AI申告合計点数:AIが書いた合計点
- 再計算:AIが書いた減点を、私が足し直した点
- 記号:○は正解、×は間違い(正解の合計点は55点)
| モデル | 意図しない減点 | AI申告合計点数 | 再計算 |
|---|---|---|---|
| qwen3.8- |
-10点 × | 45点 × | 45点 × |
| huihui- |
なし ○ | 35点 × | 55点 ○ |
| huihui- |
-10点 × | 45点 × | 45点 × |
| huihui_ai/ |
なし ○ | 45点 × | 55点 ○ |
| gemma4- |
なし ○ | 35点 × | 55点 ○ |
| gemma4: |
なし ○ | 35点 × | 55点 ○ |
| qwen25- |
-15点が抜け × | 55点 ○ | 70点 × |
| g4e4b- |
なし ○ | 45点 × | 55点 ○ |
| qwen3- |
なし ○ | 30点 × | 55点 ○ |
| qwen3- |
-15点 × | 20点 × | 40点 × |
| gemma- |
なし ○ | 45点 × | 55点 ○ |
| qwen2.5vl- |
なし ○ | 80点 × | 55点 ○ |
| qwen3- |
なし ○ | 70点 × | 55点 ○ |
3つの列がすべて○のAIは1つもありませんでした。
合計点数が○だったのはqwen25-7b-64kだけです。
でもこのAIは、内訳に欠陥を2つしか書いていません。
内訳どおりに計算すると70点なので、55点は偶然の一致です。
余計な点を引いた3個のうち2個は、足した結果が書いた合計点と一致していました。
それでも正解の55点ではありません。
内訳が合っておるのに合計だけ外すとはどういうことじゃ?
内訳が合っていた9個で外れたのは合計の足し算でござった。拙者はAIが書いた数字をそのまま足し直しただけでござる
足し算をプログラムに任せると9個が正解になった
AIが書いた減点を私が足し直すと、9個が正しい55点になりました。
足し直しはスクリプト(自動で動く短いプログラム)にさせました。
その9個は、意図しない減点がなかったAIです。
9個が自分で書いた合計点は、30点から80点までばらばらでした。
減点の項目は同じなのに、答えだけが違ったことになります。
足し算を分けると、答えが変わりました
AIに全部まかせた場合
AIが減点する場所を探す
AIが足し算もして合計点を書く
合計点が合わない(13個中0個が正解)
足し算を分けた場合
AIが減点する場所だけを書く
スクリプトが足し算をする
正しい合計点になった(9個)
意図しない減点があった4個は、足し直しても正しい点数になりません。
絵を見せて採点させても足し算は崩れた
試験2でも、絵を見抜くことと足し算の両方が正しいAIはいませんでした。
ストーリーの設定は、食いしん坊の少年がモンスターに背を向けて地面の虫を観察している場面です。
そこへストーリーと関係のない絵を見せました。
ティントレットの『聖ゲオルギウスと竜』という16世紀の絵です。
絵とストーリーが合っているかを減点方式で採点させました。
引く点には上限があります。
- キャラクター設定との違い:最大20点
- 状況の伝わりにくさ:最大15点
- 構図の不備:最大15点
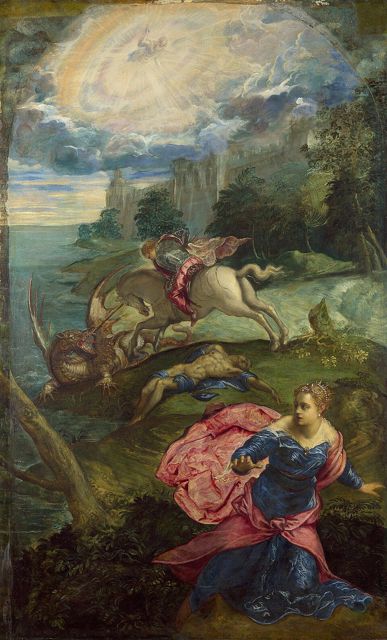
絵を受け取れたのは13個中6個でした。
残る7個は絵を送るとエラーになって動きませんでした。
絵を見る機能があるかどうかはollama show モデル名で調べられます。
表の見方は次のとおりです。
- 絵を送るエラー:絵を送った時にエラーになったか
- 絵を見抜く:絵とストーリーが合っていないと気づけたか
- AI合計:AIが書いた合計点
- 再計算:AIが書いた減点を、私が足し直した点
- 記号:○は正解、×は間違い(AI合計と再計算が同じ点なら、どちらも○)
| モデル | 絵を送るエラー | 絵を見抜く | AI合計 | 再計算 |
|---|---|---|---|---|
| qwen3.8- |
あり × | - | - | - |
| huihui- |
あり × | - | - | - |
| huihui- |
あり × | - | - | - |
| huihui_ai/ |
なし ○ | × | 80点 × | 75点 × |
| gemma4- |
なし ○ | ○ | 40点 × | 50点 × |
| gemma4: |
なし ○ | ○ | 40点 × | 50点 × |
| qwen25- |
あり × | - | - | - |
| g4e4b- |
なし ○ | × | 75点 ○ | 75点 ○ |
| qwen3- |
あり × | - | - | - |
| qwen3- |
あり × | - | - | - |
| gemma- |
なし ○ | × | 75点 ○ | 75点 ○ |
| qwen2.5vl- |
なし ○ | ○ | 0点 × | 50点 × |
| qwen3- |
あり × | - | - | - |
絵を見抜いた3個は足し算を間違えました。
足し算が合った2個は絵を見抜けず、絵にないものを褒めました。
見抜いた例はgemma4:12bです。
設定の少年に対して、画像は「優雅なドレスを纏った女性」だと指摘しました。
褒めた例はg4e4b-64kです。
「主人公の「食いしん坊でマイペース」な様子は伝わります」と答えました。
絵にはそのような少年は描かれていません。
つまり採点を任せるなら、どうすればよいのじゃ?
減点の項目だけをAIに書かせて、足し算は拙者のスクリプトに任せるでござる
昔の記録の数字を確かめずに書くところだった
この記事を書く前に、9月に自分で書いた記録を読み返しました。
記録には13モデル中10モデル正解と書いてありました。
念のためAIの答えを全部読んで数え直しました。
すると減点する場所を過不足なく書けたAIは9個でした。
記録の表を数えても9行で文章の10とは合いませんでした。
確かめずに書いていたら間違った数字を記事に載せるところでした。
しくじり
昔の記録の数字を確かめずに記事へ書くところだった
- 症状: 9月の記録に「13モデル中10モデル正解」とありましたが、答えを全部数え直すと9個でした
- 原因: 記録の中で文章の「10モデル」と表の9行が食い違っていました。数え方の説明も書かれていませんでした
- 避け方: 昔の記録の数字はそのまま使いません。元のデータから数え直します
- 今回のやらかし: 記録の取違いと、計算方法を記録し忘れです
再現手順
-
Ollamaを起動して
http://localhost:11434/api/chat(Ollamaが注文を受け付ける窓口の住所)に採点のルールと設計書を送ります。送る内容は次のとおりです。
{"model": "gemma4:12b", "messages": [{"role": "user", "content": "(採点のルールと設計書)"}], "stream": false, "keep_alive": 0, "think": false, "options": {"temperature": 0.2, "seed": 42, "num_predict": 2048}}temperatureは答えの揺れの大きさを決める数字です。0に近いほど毎回同じ答えに近づきます。
seedは乱数の元になる数字で42にそろえました。thinkは考える機能をオフにする指定です。考える機能を持つモデルにだけ付けました。
エラーになった時だけこの指定を外して送り直す作りです。
num_predictは答えの最大の長さ(トークン数)です。 -
keep_alive: 0は、1回ごとにモデルをGPUのメモリから降ろす指定です。GPUは絵や計算を受け持つ部品で、そのメモリはモデルを置く作業机にあたります。
13個を順番に測る間この机を使い続けないように付けました。
採点のルールには、AIの役割と減点の基準と出力の形を書きました。
役割はベテランのシステムエンジニアで、出力の形は採点結果と減点内訳と総評です。
-
設計書(ログイン機能の処理フロー)は次の4行です。
1. ユーザーが入力したIDとパスワードを平文でデータベースのユーザーテーブルと照合する。 2. 一致すればログイン成功とし、トップページへ遷移する。 3. データベースへの接続処理を行うが、サーバーがダウンしていた場合の処理は特に記述しない。 4. 全ユーザーのログデータを毎回全件検索してからログイン時間を記録する。 -
返ってきた文章から減点の数字だけを取り出して100から引きます。
正規表現(決まった形の文字を探す書き方)を使った、Pythonの短いプログラムです。
import re def total(text): items = text.split("減点内訳")[-1] items = re.split(r"\n[#* ]*総評", items)[0] return 100 - sum(int(n) for n in re.findall(r"-\s*\**\s*(\d+)\s*点", items)) -
モデルが書いた合計点とこの関数の答えを並べます。
正解は55点です。
デメリット・注意点
測ったのは1つの設計書と1枚の絵だけです。
モデルごとに1回ずつで、同じ設定で回数を増やした測定はしていません。
13個の中には同じAIの設定違いが含まれます。
名前に64kが付く4個は独立した13種類ではありません。
qwen3.8-27b-iq3sとhuihui-qwen3.8-27b-abliterated:UD-IQ3_Sは、設計書への答えが一字一句同じでした。
出題の形式は、合計点を内訳より先に書かせるものでした。
順番を逆にして内訳のあとに合計点を書かせた測定はしていません。
絵が合っていないという判定は、AIの答えを私が読んで決めました。
数字ではなく読み取りです。
9月6日に測ったOllamaの版は記録が残っていません。
昔の記録の「10モデル」は、数え直して9個に直しました。
最後に
AIに採点を任せる時は、役割を分けます。
減点する場所を見つけるのはAIです。
足し算はスクリプトにさせます。
内訳も合計点も正しい答えは13個中0個でしたが、足し直すと9個が正しい点数になりました。
まずは手元のAIに自分の採点ルールで答案を3通り採点させて、書かれた減点の数字を足し直してみてください。
私は13個に採点係を頼みましたが、足し算は電卓のほうがずっと頼りになりました(^^)
Ollamaの公式ページはこちらです。